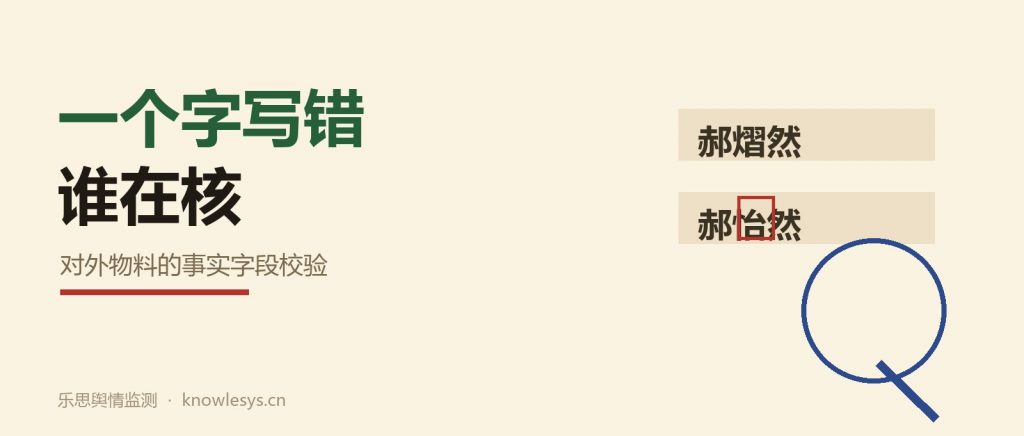
11 月 5 日上午,羽绒服品牌鸭鸭官宣郝熠然成为品牌代言人。同一天,官方旗舰店的商品标题把代言人的名字写成了”郝怡然”。
一个偏旁不同,读音相近,肉眼扫过去很容易滑过。争议起来之后,鸭鸭官方微博当天发布致歉声明,说明失误来自商品上架录入和审核环节的疏漏,已第一时间修正涉事商品标题,对相关岗位人员追责;同时在 11 月 5 日 10 时至 11 月 6 日 10 时期间下单的用户,赠送一张礼盒外的全新小卡。整改措施里有一条很具体:新增艺人相关信息的双人交叉校验机制。
处理速度不慢,态度也算清楚。但真正值得说的是另一个问题:品牌对外发布的物料里,最基础的那几个字段,往往是最没人核的。
一个品牌物料上线,通常要过几道关:创意过创意总监,文案过品牌经理,视觉过设计负责人,法务看合规风险,最后媒介或电商运营上传发布。
这几道关审的都是”好不好”和”行不行”:创意够不够抓人,表达有没有风险,画面符不符合品牌调性。
没有一道关专门审”对不对”。名字有没有写错,职务有没有写错,价格和活动规则对不对得上,参数和官方口径是否一致。这些属于事实性字段,错了不影响创意评价,也不触发合规警报,所以在一层层审美的目光里被漏掉了。
这就是为什么这类错误总发生在最基础的环节。审核链条越长,每一环都以为别人会看,结果没人看。
第一类:人名。 艺人、高管、合作伙伴、政府机构负责人的姓名和职务。生僻字、同音字、形近字是重灾区。艺人名字写错,性质比写错一个产品参数严重得多,因为它指向的是尊重。
第二类:价格与优惠。 到手价、原价、折扣力度、赠品数量、活动起止时间。这类错误在现场物料和电商页面上出现频率最高,也是投诉最集中的来源。
第三类:参数与资质。 成分含量、检测数据、认证名称、专利号、销量的统计区间。参数错一位,性质就从”表述不当”变成”虚假宣传”。
第四类:时间与地点。 活动时间、门店地址、直播场次。这类错误看似小,落到用户身上就是白跑一趟。
四类字段有一个共同点:它们都是可核对的事实,不是需要判断的表达。可核对的东西,就该有核对动作,别指望审核人的注意力。
鸭鸭在整改里加了双人交叉校验,这个动作值得展开说,因为它是把”注意力”换成了”机制”。
具体做法通常是这样:物料上线前,由制作人以外的人,拿原始资料逐字比对一遍关键字段。原始资料指的是什么?艺人方提供的官方姓名和职务说明、品牌的价格审批单、产品的检测报告、活动的审批单。比对的人不需要懂创意,只需要认字和对数。
这一步的成本很低,一份物料多花五分钟。但它能拦住绝大多数低级错误,因为错误出在”没人专门看”,跟”看的人专不专业”关系不大。
还可以再加两个动作:
建立字段清单。 把上面四类字段列成一张表,每份物料上线前过一遍。清单的好处是不依赖记忆,新人也能执行。
留痕。 谁核的、什么时候核的,记一笔。出了问题能追溯,也知道该改哪一环。
物料发出去不等于结束。这类错误的暴露速度很快,通常在上线后半小时内就有反馈。
这半小时要看的是有没有异常信号,数据好不好先放一边:
这三件事,人工刷新是能看到的,但前提是有人正在刷,而且知道该刷哪里。多数团队做不到 7×24 有人守着,尤其是晚间和周末上线的物料。
监测系统在这里的作用很有限但很实在:把品牌名、代言人名、产品名配成一组词,命中后推到负责人微信。它不会告诉你”这个名字写错了”,它只能告诉你”有人在讨论你的这条内容”。判断由人做。
第一层是修正。改掉错误,越快越好。这是必须做的,但它只是止损,不构成回应。
第二层是说明。说清楚错在哪一环,是录入、是审核、还是流程缺失。鸭鸭这次的声明落在”上架录入及审核环节的疏漏”,这个说法具体,比”工作失误”有信息量。
第三层是补偿和机制。补偿是给受影响的人一个交代,机制是给公众一个”不会再有”的依据。声明里的双人交叉校验属于第三层,这一层最能决定事件是就此结束,还是留下”道歉了但没改”的印象。
三层里最容易缺的是第三层,因为它要动流程,而动流程比写声明麻烦。
一个字的错误,成本可以很低,也可以很高,取决于它出现在哪里。内部文件里写错,改掉就行;官方旗舰店的商品标题里写错,就是一次公开的品牌事故。
这件事真正提醒的是:品牌的对外表达已经分散到了太多出口,商品标题、门店海报、直播口播、账号回复,每一个出口都在替品牌说话,而审核资源还集中在少数几个大物料上。
把这些出口当成需要校验的字段来管,比要求每个人”再仔细一点”可靠。乐思的系统能覆盖其中一部分,公众号、社交账号的公开内容都在采集范围内,命中关键词后分钟级推到微信。剩下的,得靠流程里那张字段清单。